Qu'est-ce qu'un harnais IA ?
Sujet avancéLors de mon dernier atelier cours-socrate.ai, j'ai eu le besoin d'expliquer aux élèves présents la différence entre harnais IA, modèle IA, Agent IA et IA, tout court.
Agent et harnais sont des vocables assez récents que l'on a vu apparaître ces deux dernières années et il peut être utile de les distinguer de modèle et d'IA tout court.
On va se rendre compte en étudiant la question que le serveur d'inférence du modèle est aussi un des aspects majeur de cette question et qu'on ne peut bien saisir ce qu'est un harnais sans bien comprendre le rôle du serveur d'inférence.
| Terme | Ce que c'est | Exemples |
|---|---|---|
| Modèle | Les milliards de paramètres et la structure (agencement de ces paramètres). | Opus 5.5, Fable 5.1, Qwen 3.8, GPT 6 Astra, Deepseek V4 Flash, Gemini 3.8 Flash |
| Le serveur d'inférence du modèle | L'algorithme qui calcule les prochains mots jusqu'à la fin du tour, et fait l'analyse syntaxique pour reconnaître: raisonnement, réponse, et appel aux outils. Situé entre le modèle et le harnais, il est également en charge de la standardisation des formats de sorties de modèles en un format JSON qui peut être facilement lu par le harnais. | vllm, llama.cpp, Ollama, LM Studio, SGLang, serveur d'inférence propriétaire Anthropic ou OpenAI, .. |
| Harnais | 1/ La UI qui vous permet de parler avec le modèle sous un format "chat". 2/ Le texte ajouté au contexte (définition des outils, des skills, AGENTS.md, CLAUDE.md, l'adresse du dossier du projet, ..). 3/ la couche software qui agit (appel aux fonctions "write", appel "bash", ..) et renvoie le résultat de ces opérations au serveur d'inférence. | Claude Code, Codex, Cursor, Pi, OpenCode, Hermes, Openclaw |
| Agent | Un modèle, son serveur d'inférence et son harnais, mis ensemble. | Pi + vllm + Qwen 3.8 27B; Claude code + serveur d'inférence claude propriétaire + Claude Opus 5.5 |
Le reste de l'article apporte une explication à chacune de ces lignes, autour d'exemples concrets.
Qu'est-ce qu'un modèle IA ?
Le modèle, on peut dire que c'est le moteur, la base sur laquelle repose tout. Sonnet 5, Fable 5.1, GPT 6 Astra, Gemini 3.8 Flash, etc. En général on les nomme avec leur version à côté (ex : Fable 5.1).
Le modèle, ce sont les milliards de nombres (aussi appelés poids ou paramètres) qui vont permettre de faire le calcul de la probabilité du prochain mot que la machine va vous dire. Et ces poids sont organisés selon une structure particulière. Cette structure détermine l'ordre dans lequel les opérations vont être effectuées, c'est à dire comment ces poids vont être multipliés aux entrées du modèles (les mots que vous allez lui dire) pour produire la probabilité du prochain mot. Actuellement la structure qui est utilisé, et depuis 2017, est celle du Transformer, améliorée progressivement depuis.
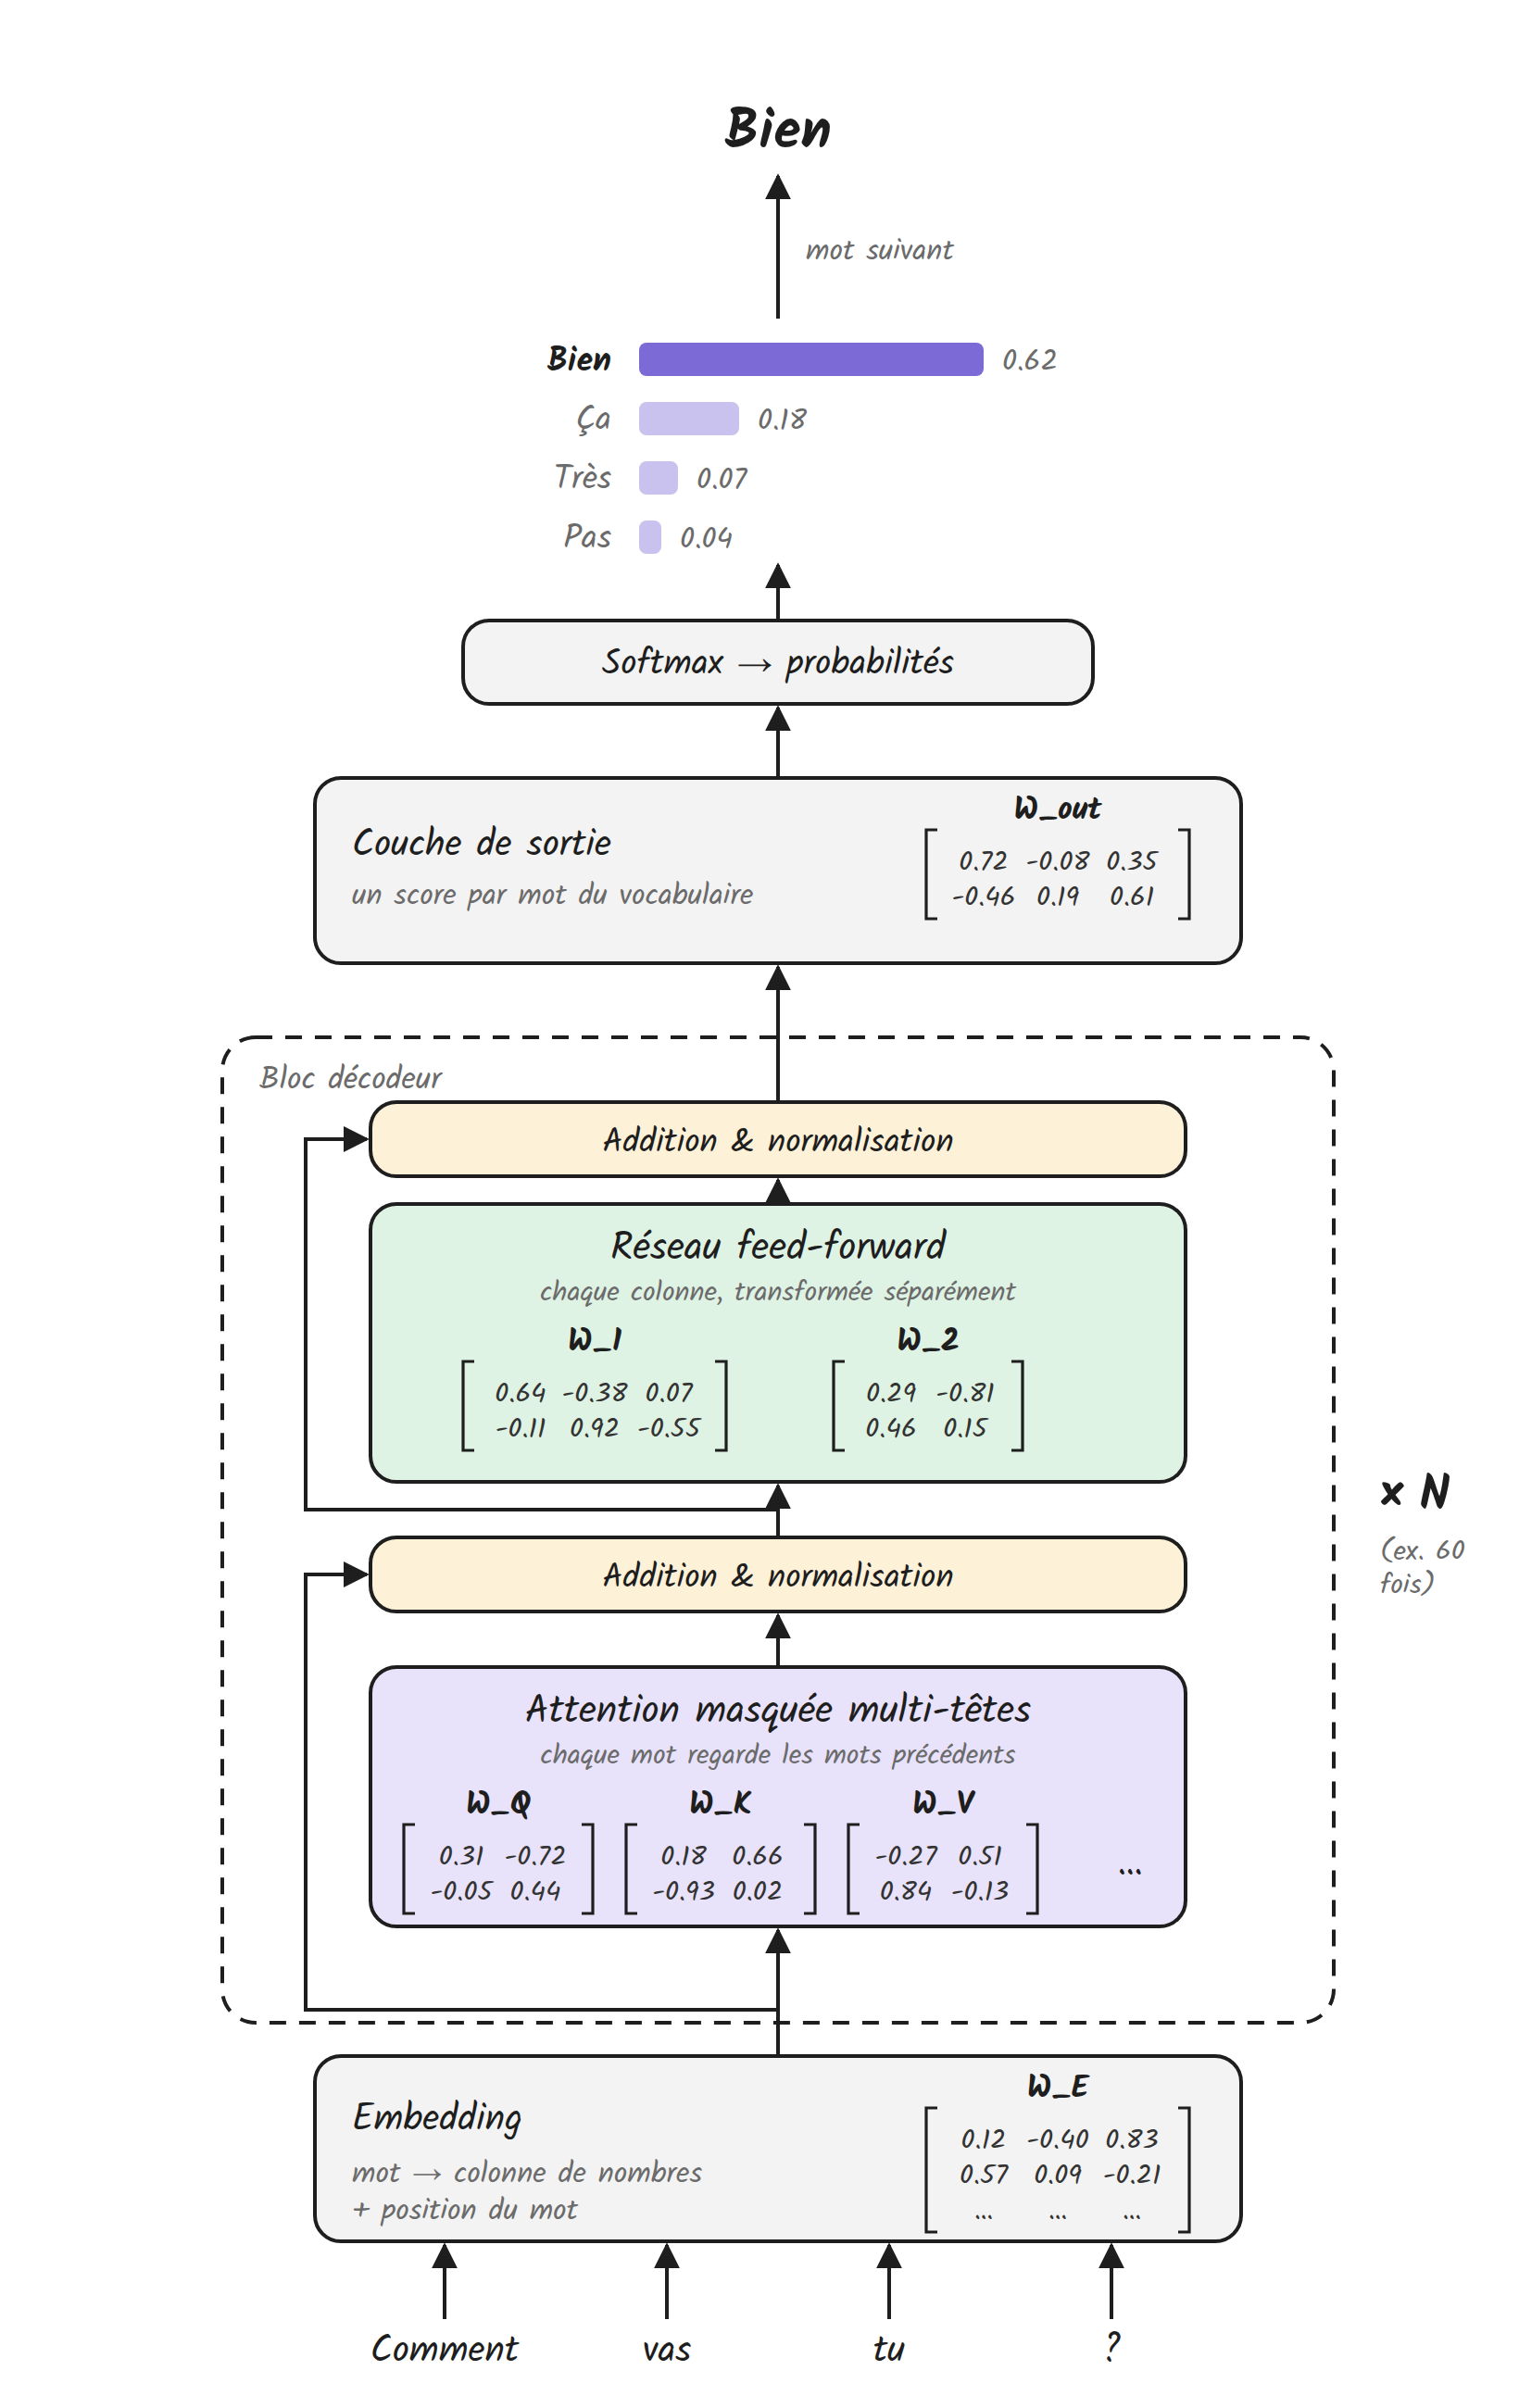
Dans le schéma 1 (plus bas) on représente la structure d'un Transformer. Il n'est pas nécessaire de la comprendre précisément pour les besoins de cet article.
En revanche, ce qui est utile de comprendre c'est ce qu'est le modèle dans ce schéma :
- les paramètres : les différents tableaux de nombres W_1, W2, WQ, W_K, WV, WE
- la position de ces paramètres dans la succession des calculs qui vont être faits.
Le modèle est la partie la plus mathématique de l'IA. Les milliards de paramètres ont été ajustés peu à peu (on dit aussi que le modèle a été entraîné) sur des quantités astronomiques de texte, de façon à produire du texte qui ait du sens et qui soit utile pour les utilisateurs (c'est-à-dire nous).
Mais en soit le modèle est plat, inerte, c'est un fichier qui contient ces milliards de nombres.
C'est le serveur d'inférence qui s'occupe du calcul.
Qu'est ce que le serveur d'inférence du modèle IA ?
Commençons par quelque noms classiques de serveur d'inférence de modèles : vllm, llama.cpp, Ollama. Les modèles fermés (d'OpenAI, Anthropic par exemple) ont leur serveurs d'inférence, mais nous ne leur connaissons pas de noms particuliers.
Expliquons maintenant ce qu'ils font.
Calcul du prochain mot
Le serveur s'occupe d'abord du calcul de la probabilité du prochain mot. Il :
- charge les poids du modèle sur le processeur (CPU ou GPU)
- fait passer le texte en entrée du modèle
- réalise la succession des opérations jusqu'au calcul de la liste de probabilité du prochain mot (dans le schéma : Bien=0.62; Ça=0.18; Très=0.07, etc.)
- tire au sort parmi ces probabilités le prochain mot, avec certaines configurations (les paramètres top-k, température, etc.)
Une fois ce premier mot sorti, le serveur le prend, le rentre lui-même dans le modèle et reproduit les opérations ci-dessus pour produire une nouvelle liste de probabilité du prochain mot. Il continue ainsi, jusqu'à produire le token de fin de tour de conversation (fin de la réponse de l'assistant).
Analyse syntaxique et standardisation du format de sortie
Il fait également l'analyse syntaxique du texte produit, ce qui permet de découper le texte produit en : raisonnement, réponse du modèle proprement dite, et appels à outils. Pour se donner une idée de ce qu'est le raisonnement, sur les modèles fermés (OpenAI, Claude), c'est tout le texte écrit que vous ne voyez pas, lorsque Claude vous dit qu'il réfléchit et qu'il n'écrit rien. (Quelquefois, c'est long..).
Cette analyse syntaxique est cruciale. En effet, elle permet de rendre la sortie du modèle agnostique. Que veut-on dire par là ? Et bien commençons par préciser que les modèles ont chacun leur façon propre d'écrire du texte. En voici deux : une au format Mistral, une au format Qwen.
- Format Mistral:
[THINK]L'utilisateur veut la météo à Paris. Je n'ai pas cette info, je dois appeler l'outil get_weather.[/THINK] Je regarde la météo à Paris. [TOOL_CALLS]get_weather[ARGS]{"city": "Paris"}</s> - Format Qwen3:
<think>
L'utilisateur veut la météo à Paris. Je n'ai pas cette info, je dois appeler l'outil get_weather.
</think>
Je regarde la météo à Paris.
<tool_call>
{"name": "get_weather", "arguments": {"city": "Paris"}}
</tool_call><|im_end|>
Grâce à l'analyse syntaxique des parties du texte, quel que soit le modèle, un serveur d'inférence tel que vllm (au format Chat completions ici) va ressortir exactement le même objet pour ces deux textes : le JSON suivant.
{
  "role": "assistant",
  "reasoning": "L'utilisateur veut la météo à Paris. Je n'ai pas cette info, je dois appeler l'outil get_weather.",
  "content": "Je regarde la météo à Paris.",
  "tool_calls": [
    {
      "id": "call_abc123",
      "type": "function",
      "function": {
        "name": "get_weather",
        "arguments": "{\"city\": \"Paris\"}"
      }
    }
  ]
}
Notez qu'on retrouve bien dans cet objet la partie raisonnement, la partie réponse à proprement parler, et la partie appel à un outil.
On prendra un peu plus de temps à la fin de cet article (voir Et comment marche-t-il, ce harnais ?) pour expliquer comment se passe ensuite à proprement parler l'appel à un outil.
Pourquoi homogénéiser les sorties du modèles ? Et bien, comme ça, n'importe qui peut se brancher au modèle et l'on n'a pas besoin de connaître le format de celui-ci, puisqu'une interface est là qui est la même pour tout le monde. Ce sera critique pour la suite, lorsque va intervenir le harnais. Nous allons l'expliquer plus bas, il va se connecter au modèle. Autant que le format soit le même pour que l'on puisse ainsi se brancher au modèle sans savoir son format. Une nuance à apporter tout de même : il n'y a pas exactement un seul format de sortie du serveur d'inférence. Il y en a quelques uns. Les voici :
- Openai chat completions. Sorti en 2023, c'est le format le plus standard actuel. Les serveurs vLLM, llama.cpp, SGLang, LM STudio et Ollama l'exposent.
- Openai responses. Une évolution par rapport à chat completions qui existe depuis 2025.
- Anthropic message API
- Gemini a aussi son format
Notez toutefois qu'il y a beaucoup moins de format de sortie JSON (il y a principalement les 4 mentionnés ci-dessus) qu'il n'y a de formats de modèles (des dizaines; chaque laboratoire a le sien : Mistral, Qwen, DeepSeek, GLM, Kimi, gpt-oos, etc.). C'est donc effectivement une très large standardisation que permet le serveur d'inférence. Comme il y a peu de standards, le harnais n'a a implémenter que 4 formats pour pouvoir se connecter au serveur sans avoir besoin de connaître le format exact d'écriture de chacun des modèles.
Exposition API
Une dernière chose faite par le serveur du modèle, c'est d'exposer une API permettant d'appeler le modèle.
Lorsque vous lancez vllm pour un modèle monté sur une carte graphique locale, il ouvre un serveur http et vous pouvez par exemple passer vos appels API sur l'adresse http://localhost:8000/v1/chat/completions.
Une passe de prédiction
Ci-dessous, on représente le schéma d'un modèle (avec quelques uns de ses poids) et une passe de production d'un mot par le serveur d'inférence. En entrée arrivent les mots : "Comment vas-tu ?", en sortie le premier mot qui sort est "Bien". On ne représente pas les étapes suivantes du serveur d'inférence : futurs mots produits, analyse syntaxique et production du JSON.
Il n'est pas nécessaire de comprendre chaque ligne de ce schéma, ce qui compte c'est de comprendre que via le serveur d'inférence des mots rentrent en bas et un mot sort en haut. Au milieu se situe les paramètres du modèle (tableaux de nombres W_1, ..W_E) qui ont été entraînés pour calculer la liste de probabilité du prochain mot.
Comme nous l'avons présenté ci-dessus, le serveur d'inférence permet une standardisation des sorties du modèles pour que le harnais puisse se connecter. Alors, justement, qu'est ce que ce harnais ?
Qu'est ce qu'un harnais IA ?
Le harnais se « pose » sur le modèle et son serveur d'inférence. On appelle ça harnais car ça se compare tout à fait au harnais qui se pose sur les chevaux d'une calèche : le harnais s'accroche au cheval pour transmettre la puissance du cheval à la calèche, comme le harnais IA s'accroche au modèle et à son serveur pour transmettre la puissance du modèle à l'utilisateur.
Pour comparer aux noms de modèles et de serveurs indiqués plus haut, voici quelques noms de harnais : Claude Code, Codex, Cursor, Pi, Opencode, Openclaw, Hermes.
Notez que contrairement aux modèles, on évoque rarement la version du harnais. En réalité, on devrait aussi le faire, car ces harnais ont évidemment aussi des versions qui évoluent, mais dans les faits, on laisse souvent ça sous silence.
Très bien pour les noms, mais maintenant, plus précisément : qu'est-ce que le harnais IA ?
Un exemple : une question de calcul
Prenons un exemple simple et voyons où intervient ce harnais. Nous allons poser une question de calcul un peu complexe à un agent et voir ce qu'il se passe.
Oups, je parle d'agent sans trop avoir défini ce dont il s'agit. J'anticipe un peu car c'est utile pour expliquer : l'agent, c'est tout simplement le modèle et son serveur d'inférence, plus son harnais. On en dira quelques mots de plus ci-bas.
Revenons à nos moutons. Pour poser ma question, j'utilise l'agent suivant :
- harnais : Pi — un excellent harnais Open Source sur lequel je vais bientôt faire un article spécifique ;
- modèle : Qwen 3.8 27B, qui est monté sur ma carte graphique locale.
- serveur d'inférence : vllm
Vous voyez bien ici la décomposition : harnais + modèle + serveur. Et notez que j'aurais très bien pu décider d'utiliser exactement ce même harnais, mais avec un autre modèle (un modèle Claude Opus 5 par exemple) et le serveur d'inférence idoine.
Voilà la question de calcul :
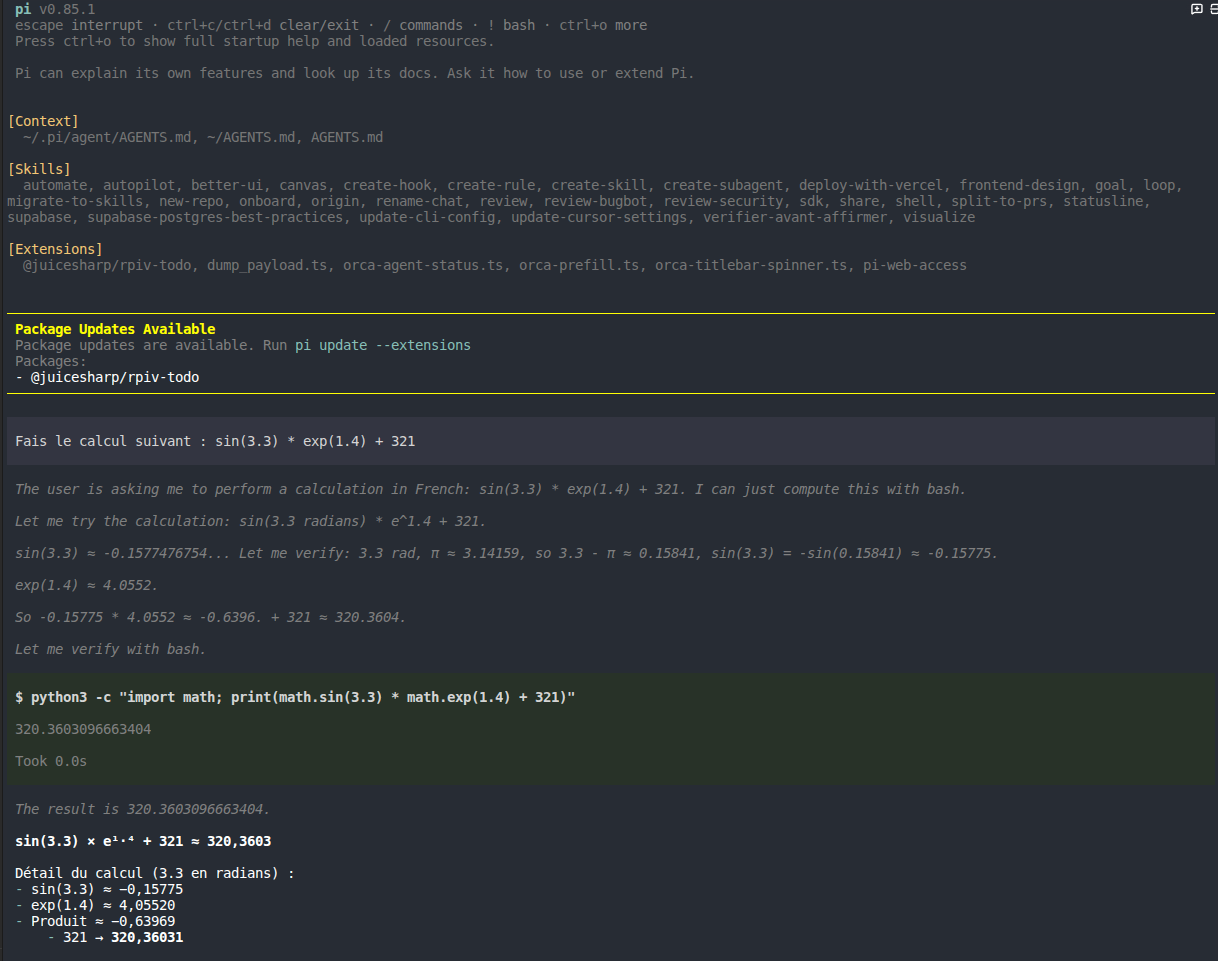
Fais le calcul suivant : sin(3.3) * exp(1.4) + 321
Et voici l'échange complet avec l'agent :
le b.a.-ba : la UI
Commençons par ce qui saute aux yeux mais qu'on a finalement tendance à laisser sous silence. Le harnais s'occupe déjà de l'interface utilisateur. Sans lui, impossible de parler aussi simplement avec un modèle et son serveur qui ne parlent qu'en JSON.
Le harnais convertit les sorties du serveur d'inférence sous format JSON en votre interface utilisateur classique, que vous voyez ici : les mots dits par l'utilisateur d'un côté, la réponse du modèle (via son serveur) de l'autre.
Mais, comme vous le voyez, c'est loin d'être tout ce que fait le harnais : il parle beaucoup avant même d'afficher notre question. Alors que fait il de plus ? Nous allons le voir tout de suite.
Qui parle, à quel moment ?
À partir de cet exemple simple, voyons quelques endroits où intervient le harnais, et où il n'intervient pas à proprement parler.
| Moment de l'échange | Qui écrit/agit ? |
|---|---|
| Contexte, skills, extensions | harnais |
| Mon message « Fais le calcul suivant… » | moi |
| Raisonnement en italique ("The user is asking ..."), puis demande d'outil | modèle via le serveur d'inférence |
| Exécution de la commande bash ("python3 -c ..."), résultat renvoyé ("320.36..") | harnais |
| Raisonnement final ("The result is .."), puis réponse récapitulative ("sin(3.3)...") | modèle, via le serveur d'inférence |
On voit que dans toute cette conversation, en fait ce n'est pas un, mais trois acteurs qui se combinent et se parlent :
- moi (l'utilisateur de l'agent)
- le modèle d'IA, via le serveur d'inférence, qui produit du texte
- le harnais qui rajoute du contexte, exécute les tâches demandées par le modèle et renvoie les résultats
Rentrons maintenant plus encore dans le détail : de ce qui est ajouté avant la conversation, puis de la conversation elle-même.
Ce que le harnais ajoute avant la conversation
| Élément ajouté | À quoi ça sert |
|---|---|
[Context] (en orange) | 3 fichiers AGENTS.md qui donnent des directions générales à suivre |
| Définitions des formats d'appels des outils | Non visibles ici, mais bien rajoutés au contexte : read, write, edit, bash. Ces définitions de format d'outils permettent au modèle de savoir ensuite comment demander l'appel de ces fonctions. |
| Descriptions des skills | Au fur et à mesure de sa production de mots, si le modèle détermine qu'il a besoin de l'un de ces skills (grâce à cette description contextuelle), il va faire la demande de charger leur fichier texte associé |
| Extensions Pi | Un mélange de texte et de code qui raffine encore l'agent |
Quelques précisions sur ces quatre lignes :
- Les trois
AGENTS.mddonnent un contexte général à la conversation. Dans~/AGENTS.md, je donne des informations sur moi, mon parcours, un CV court en quelques lignes, utiles pour améliorer les réponses. C'est un fichier qui est chargé quel que soit le harnais que je choisis (claude, pi, opencode, etc.). Dans~/pi/agents/AGENTS.md, je donne des informations spécifiques à l'agent Pi, ici de me répondre en français (je l'ai mis dans celui-ci car j'ai noté qu'avec Pi, on me répondait plus souvent en anglais si je n'ajoutais pas ce fichier). A bien noter que ces deux premiers fichiers sont utilisés dans toutes les conversations Pi. Dans le dernier fichier,AGENTS.mdau niveau du projet, je mets des informations spécifiques au projet : par exemple, dans un projet Next.js, on met souvent l'instruction d'aller chercher la doc récente Next.js, pour que le modèle ne se serve pas de ce qu'il a en mémoire, et qui peut être daté. Ce fichier n'est utilisé que dans le cadre des conversations Pi que j'ai dans le cadre de ce projet spécifique. - Les définitions de format d'appel des outils. Pi, qui est un harnais très léger, ne définit que 4 outils de base :
read,write,editetbash. C'est peu, mais c'est déjà beaucoup : avec ça on peut presque tout faire, et l'intérêt d'en avoir très peu, c'est que le contexte reste léger (il coûte donc moins de tokens). Pour voir leurs définitions vraiment, il faudrait regarder les tokens que voit le modèle — je le ferai et vous le partagerai dans un autre article très bientôt. - Les descriptions des skills. J'en ai ici une vingtaine (c'est beaucoup, ça coûte du contexte, je pourrais songer à réduire) —
frontend-designetbetter-uipour améliorer le rendu des UI,supabasepour mieux me connecter à ma base de données, et un skill persoverifier_avant_affirmerqui force le modèle à vérifier sur internet quand il n'est pas sûr. - Les extensions. Par exemple
pi-web-accessoutodo-list. Les extensions Orca, elles, permettent de se connecter au système multi-agent Orca. (Je ferai un article sur ce système bientôt, également.)
Je saute la partie « Packages update available » : c'est un simple affichage de Pi sur des mises à jour à faire, sans rapport avec l'agent.
La conversation elle-même
Vient ensuite la conversation proprement dite. Ici, il ne s'agit plus du harnais. On voit :
- mon entrée « Fais le calcul suivant : … ». Elle entre dans le modèle IA, via le serveur d'inférence, qui va la lire et produire…
- …la partie raisonnement du modèle (en italique) : « The user is asking, etc… ». À la fin de cette partie, on voit très bien que le modèle propose de vérifier avec bash : « Let me verify with bash ».
Le harnais reprend alors le contrôle :
- il lance la commande
python3 -c "import math; print(math.sin(3.3) * math.exp(1.4) + 321)"; (voir dans la section plus bas "Comment marche-t-il ce harnais" pour découvrir comment le harnais sait qu'il doit passer cette commande"). - il renvoie le résultat
320.xxxdans la conversation.
La conversation reprend, ce n'est à nouveau plus le harnais qui est en jeu :
- à nouveau une partie raisonnement du modèle : « The result is 320.xxx » ;
- puis la réponse du modèle, qui récapitule :
sin(3.3) × e¹·⁴ + 321 ≈ 320,3603
Détail du calcul (3.3 en radians) : sin(3.3) ≈ −0,15775 · exp(1.4) ≈ 4,05520 · produit ≈ −0,63969 · + 321 → 320,36031
Ouf, on a fini ! Sur cette toute petite conversation, on voit qu'il y a déjà beaucoup d'échanges entre harnais et modèle.
C'est tout ce qu'il fait, ce harnais ?
En fait le harnais, à proprement parler, c'est trois choses :
| Une UI | Des éléments de texte | Une partie software | |
|---|---|---|---|
| Quoi | L'interface graphique utilisateur pour échanger avec le modèle | Du texte qui s'ajoute à la conversation (le contexte augmenté des outils, vu plus haut) | Du code qui s’exécute autour de la conversation proprement dite (par exemple qui lance les outils read ou bash vu plus haut) |
| Vu par le modèle ? | Non : le modèle ne sait rien de l'interface utilisateur | Oui, intégralement | Non : le modèle ne voit pas qu'on lance une commande bash, seulement les résultats que le harnais décide de réinjecter |
En ça, on le voit, le harnais est très « informatique », « software », contrairement au modèle, qui est d'un aspect plus mathématique. Le harnais, on peut donc dire que c'est une UI, de l'ingénierie de contexte, plus une couche software que l'on rajoute au modèle et à son serveur d'inférence.
Dans l'exemple plus haut, on n'a en fait vu que quelques éléments d'un harnais (définitions des tools, des skills, appel des tools), mais il y en a d'autres.
Côté texte, ce que le harnais peut encore ajouter au contexte :
| Élément | Effet |
|---|---|
| Le dossier du projet | Comme le modèle sait où l'on travaille, il peut décider très naturellement de lister les fichiers déjà présents . Quand on travaille sur un répertoire de code, c'est souvent la première étape que l'on voit être effectuée par le harnais en début de conversation après que l'on lui a demandé quelque chose : read README.md, read package.json, etc. |
| L'état git | Optionnel, selon le harnais |
| La date et l'heure | Optionnel, selon le harnais |
Certains éléments dépendent d'un harnais à l'autre : le harnais Pi (je viens de le vérifier) n'ajoute par exemple nativement ni l'état git, ni la date. En revanche, rien n'empêche le modèle de décider, de façon ad-hoc, de demander au harnais une commande bash demandant l'état git, qui lui renverra ces éléments. Ce n'est juste pas natif dans le harnais.
Côté software, ce que le harnais fait encore :
| Fonction | Ce qu'il se passe |
|---|---|
| Auto-compaction | Quand le contexte approche du maximum, il résume la conversation dans un fichier mémoire, supprime le contexte actuel, et relance le modèle avec ce fichier (bien plus petit) |
| Chargement des skills | C'est lui qui va chercher les fichiers de skills et les rajoute dans le contexte lorsque le modèle demande de les charger |
| Hooks | Il exécute certains scripts automatiques (appelés hooks) à lancer avant ou après l'appel d'un outil |
| Permissions | Quand un outil doit être appelé, il vérifie les droits pour exécuter cet outil. C'est ici qu'intervient le choix que vous avez fait dans Claude Code par exemple : mode plan, auto ou bypass |
| Sous-agents | Il peut en lancer, récupérer leur résumé et l'envoyer dans le contexte |
| Résultats d'outils | Il coupe les sorties trop longues et remonte les erreurs au modèle pour qu'il se corrige |
| Mémoire persistante | Il vous permet de basculer d'une session à l'autre, (/resume dans Claude Code pour récupérer une conversation précédente) |
En réalité, il y a tellement de sujets qu'un harnais peut ajouter que je ne les liste pas tous ici, mais vous en avez déjà une bonne vision. Chaque développeur de harnais peut ajouter toute surcouche de software qu'il juge nécessaire (sauvegardes, etc.).
Le fait de développer un nouveau harnais qui rajoute ou enlève certaines parties de contexte ou certains morceaux de software, s'appelle le "harness engineering" ou ingénierie de harnais.
Et comment marche-t-il, ce harnais ?
Je crois que c'est la partie la plus étonnante de cet article.
Lorsque je pose la question de calcul, le modèle commence à produire :
- son raisonnement : « The user is asking, etc… » ;
- puis du texte qui demande l'appel d'une fonction bash, laquelle appelle une fonction Python ;
- un token de fin de conversation.
Notez bien ici que le modèle, lui, ne produit que du texte. Alors comment est-ce que la fonction est vraiment appelée ?
Eh bien, comme nous l'avons vu plus haut, le serveur d'inférence du modèle va faire une analyse syntaxique du texte produit (« parser » le texte) pour reconnaître les différentes parties : 1/ le texte de raisonnement, 2/ le texte demandant l'appel à une fonction avec ses arguments. Grâce à cette analyse, il produit un JSON contenant : le raisonnement d'un côté, et les outils à appeler de l'autre.
Une fois ce JSON construit, c'est Pi (le harnais) qui prend le relais et décide, si les permissions l'autorisent, du lancement des outils (ici commande bash qui exécute du python). Lorsque le calcul est fini, la sortie de la commande est envoyé au serveur d'inférence du modèle, qui va l'ajouter à la suite du texte de la conversation (concaténation), et lancer sa production de mots. Le serveur d'inférence génère alors : son raisonnement (« The result is 320.3603096663404. ») puis la réponse finale ("**sin(3.3) × e¹·⁴, etc.").
Ce qui est tout à fait étonnant ici, c'est la succession :
| Dans la conversation | Origine |
|---|---|
| « The user is asking… » + texte demandant l'outil | texte généré par le modèle via son serveur d'inférence |
320.3603096663404 | résultat du tool, renvoyé par le harnais au serveur d'inférence, qui le colle à la suite de la conversation (concaténation) |
| « The result is… » + réponse finale | texte généré par le modèle via son serveur d'inférence |
Une partie du texte de la conversation est donc générée, tandis qu'une autre est simplement « collée ».
Une dernière chose que nous avons passé sous silence : à quoi ressemble véritablement ce "texte demandant l'outil" ?
Et bien dans le cas de notre conversation, le voici : <tool_call><function=bash><parameter=command>python3 -c "import math; print(math.sin(3.3) * math.exp(1.4) + 321)"</parameter></function></tool_call>
Notons d'abord que ce texte est propre au harnais Pi. Dans le cas d'un autre harnais le texte serait sous une forme similaire mais différente.
Ensuite, et c'est le plus important, on voit que ce texte est très structuré. L'appel à la fonction est entouré par des balises et c'est cela qui va ensuite permettre au serveur d'inférence de faire l'analyse syntaxique pour extraire la demande d'appel à une fonction.
Pour voir ce sujet plus précisément, nous ferons très bientôt un nouvel article : « Qu'est-ce que "voit" le modèle ? ». Il détaillera cette succession et l'encadrement des différentes parties de la conversation par des balises : <think>, <tool_call>, <tool_result>… Stay tuned !
Qu'est ce qu'un agent IA ?
Nous avons déjà défloré le sujet ci-haut, mais répétons le à nouveau, un agent IA, c'est tout simplement :
- un modèle
- son serveur d'inférence
- combiné à un harnais
Notez que dans la conversation, agent et harnais sont souvent confondus l'un pour l'autre et l'on entend souvent parler de Claude Code comme d'un agent, alors que techniquement on devrait plutôt parler de harnais. Pareil pour Pi, on entend certains parler de Pi agent, alors que Pi est plutôt le harnais. Cette confusion n'a aucune gravité, et pas d'impact dans les faits.
Qu'est ce que l'IA ?
Maintenant que nous avons défini tous ces termes, nous pouvons passer à la définition d'IA.
L'IA, c'est tout simplement, par métonymie, l'un ou l'autre des éléments évoqués ci-dessus :
- un modèle
- un modèle et son serveur d'inférence
- un harnais connecté à un modèle par son serveur d'inférence
- ou un agent complet !
Si vous avez aimé cet article, partagez-le sur vos réseaux !
À bientôt, sur le blog de Cours-socrate.ai
Le meilleur moyen d'apprendre, c'est de faire.
Inscrivez-vous au cours : le lundi soir, un groupe de maximum 10, Paris ou en visio.